 Analyzegear
CSV の1列を見て「部署ごとに何件」を数え、多い順に並べる。集計の仕事で何度も書く処理です。よく見かける書き方を10言語で試したところ、10言語すべてが前後の空白を落として母数を変え、列の足りない壊れた行まで数えました。 さらに、同じ件数のまとまりの並び順が4言語で違いました。
何をしたか
CODE Polyglot の「よく使う書き方」 で、決まりを先に決めました(正解表15件)。
- 「<キー> <件数>」を件数の多い順に。件数が同じなら、キーを Unicode のコードポイントの小さい順
- 最後に「合計 <数えた行の数>」。列の数が見出しと違う行は数えず、「読めない行 <数>」として出す
- 前後の空白は取らない(「 営業」と「営業」は別)。大文字と小文字も別
10言語(PHP・Python・JavaScript・Go・Java・C#・Rust・Ruby・Kotlin・Swift)で書き、よく見かける書き方(連想配列で数えて、件数の多い順・同じなら名前順に並べるもの)も10言語で用意して、同じ正解表で動かしました。
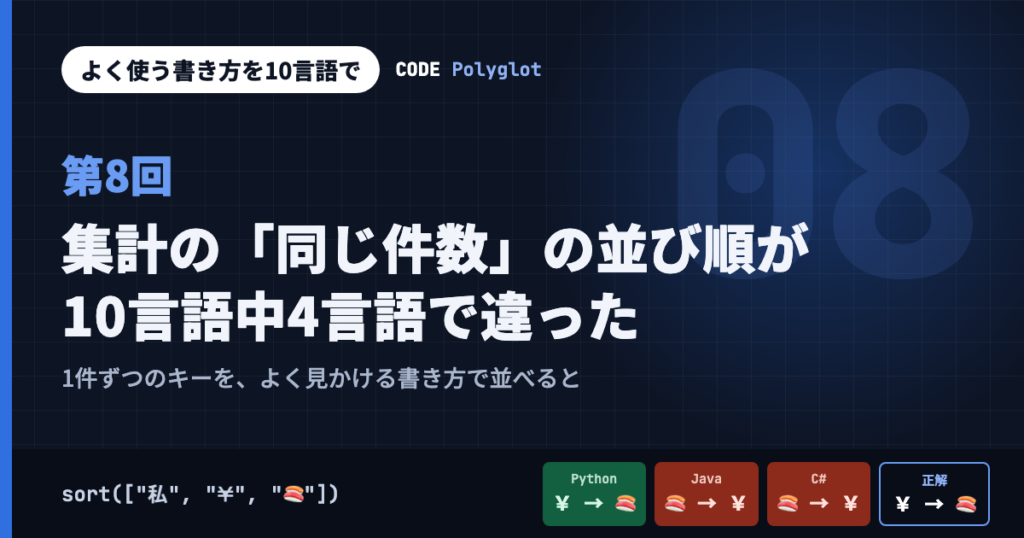
同じ件数のときの並び順が、4言語で違った
キーが 私・¥・🍣 の3つ(どれも1件)のケース(c003)の結果です。
| よく見かける書き方 | 答え | 言語 |
|---|---|---|
| 決まり(コードポイント順) | 私 → ¥ → 🍣 | PHP・Python・Go・Ruby・Rust・Swift |
| UTF-16 の並び | 私 → 🍣 → ¥ | Java・Kotlin・JavaScript・C#(10言語中4言語) |
🍣 は U+1F363、¥(全角の円記号)は U+FFE5 です。コードポイントなら ¥ が先ですが、この4言語の文字列は中身が UTF-16 で、🍣 は U+D83C U+DF63 のサロゲートペアとして入っています。先頭の 0xD83C は 0xFFE5 より小さいので、compareTo や < で比べると 🍣 が先に来ます。
直すには、UTF-8 のバイトの並びで比べます(UTF-8 のバイト順は、コードポイント順と同じになるように作られています)。
// Java・Kotlin: byte は符号付きなので compareUnsigned(Java 9 から)
Arrays.compareUnsigned(a.getBytes(StandardCharsets.UTF_8), b.getBytes(StandardCharsets.UTF_8));
// JavaScript: Buffer で比べる(a < b は UTF-16 の並び)
Buffer.compare(Buffer.from(a, "utf8"), Buffer.from(b, "utf8"));Arrays.compare(符号付き)のままだと、0x80 以上のバイトが負の数になって、日本語が ASCII より先に来ます。
PHP は 2 → 9 → 10 になった
キーが 10・2・9(どれも1件)のケース(c009)で、PHP だけが 2 → 9 → 10 の順になりました。決まりはコードポイント順なので 10 → 2 → 9 です。
var_dump("10" <=> "2");     // int(1)  … 数として比べている
var_dump(strcmp("10", "2")); // int(-1) … 文字として比べている
PHP 8 の <=> は、両方が数字だけの文字列なら数として比べます。商品コード・郵便番号・社員番号のような「数字でできた文字列」をキーにするときは、strcmp を使うか、文字として比べることを明示します。
PHP の配列は "10" のようなキーを整数の 10 に変えてしまうので、比べる直前に (string) で戻すところまで必要でした。
Swift は「が」を1つにまとめた
「が」1文字(U+304C)2件と、「か」+濁点(U+304B U+3099)1件を数えたケース(c005)で、Swift だけが が 3 と答えました(決まりは が 2 と が 1 の2行)。
Swift の String は、== もハッシュも「正規化して同じなら同じ」と決まっています。画面に出す言葉を数えるぶんには親切ですが、元のデータのとおりに数えたいときは別物として扱う必要があります。
// String ではなく UTF-8 のバイトの並びをキーにする
var counts: [[UInt8]: Int] = [:]
counts[Array(key.utf8), default: 0] += 1
前後の空白を落とすと、母数が変わる(10言語中10言語)
営業2件・ 営業1件・営業 1件を数えたケース(c007)で、よく見かける書き方は10言語すべてが 営業 4 と答えました。trim()(PHP は trim、Python は strip、Go は TrimSpace)を通すのは親切な処理に見えますが、集計の母数が変わります。
空白を落としてまとめたいなら、それは仕様です。そう決めていないなら落としません。実務では「取り込みのときに空白を落として保存する」のか「集計のときだけ落とす」のかを先に決めておくと、数が合わない相談が減ります。
壊れた行まで数える(10言語中10言語)
列が1つ足りない行と、1つ多い行を混ぜたケース(c010)です。よく見かける書き方は10言語すべてが同じ答えでした。
| 営業 | 開発 | 総務 | 合計 | 読めない行 | |
|---|---|---|---|---|---|
| 決まり | 3 | 2 | 1 | 6 | 2 |
| よく見かける書き方(10言語) | 4 | 3 | 1 | 8 | (出さない) |
line.split(",")[1] は、列が足りない行でもたまたま何かを返すことがあります。キーの列が左のほうにあると、壊れた行がそのまま集計に混ざり、合計だけが少し多くなります。見出しと列の数を比べて、合わない行を別に数えて出すのがいちばん簡単です。「読めない行 2」が出れば、取り込みの元を直すきっかけになります。
列の数を数えるので、split の仕様にも気をつけます。Java の String.split(",") と Ruby の split(",") は末尾の空の欄を捨てます(第2引数に -1 を付けると残る)。Swift の split(separator:) は既定で空の欄をすべて捨てます(omittingEmptySubsequences: false が要る)。
同じコードが、動かす場所で違う順番を出した
C# の OrderBy(キー) や string.CompareTo は、動かす場所の国の設定(カルチャ)に従います。同じ naive のコードで、落ちたケースの数が2か所で違いました。
| 動かした場所 | 結果 | 追加で落ちたケース |
|---|---|---|
| 検証に使っている Linux のコンテナ(ICU なし) | 15件中12件 | ― |
| 手元の Mac(ICU あり) | 15件中10件 | c002(漢字の並び)・c004(a と A の並び) |
ICU(国ごとの並べ方の表)があると「辞書の順」に並び、a が A より先に来ます。機械が読む出力やテストで比べる出力には、StringComparer.Ordinal のように国の設定に左右されない比べ方を選びます(それでも UTF-16 の並びなので、絵文字は上の表のとおりです)。
まとめ
- 集計の表は「多い順」だけでは順番が決まらない。同じ件数のときの並びまで決める。連想配列を回す順番は、Go・Rust・Swift では動かすたびに変わる
- 同じ件数のときのキーの順は、UTF-16 で比べる4言語(Java・Kotlin・JavaScript・C#)で変わる。UTF-8 のバイトで比べるとそろう
trimと「列の数を確かめない」は、10言語すべてで答えを変えた。親切な処理と、黙って混ざる壊れた行に気をつける
10言語のコードと全15件の結果は CODE Polyglot「キーでまとめて数える(group by)」 にあります。
- 第1回:HTML のエスケープ、標準の関数の答えが言語ごとに違った
- 第2回:「2026-02-30T09:00:00Z」を、4言語の標準のパーサーが3月2日として読んだ
- 第3回:「getHTTPResponseCode」をスネークケースに、よく見かける書き方は10言語中9言語で崩れた
- 第4回:アクセスログを空白で区切って集計したら、10言語すべてが壊れた行を数えた
- 第5回:重複を消したら順番が変わった、Swift は「が」を1つにまとめた
- 第6回:İstanbul の slug が5通りに割れた、日本語のタイトルはそのまま URL に入った
- 第7回:URL エンコードで空白が「+」になったのは10言語中6言語、~ を変えたのは4言語
- 第8回:集計の「同じ件数」の並び順が10言語中4言語で違った(この記事)