 Analyzegear
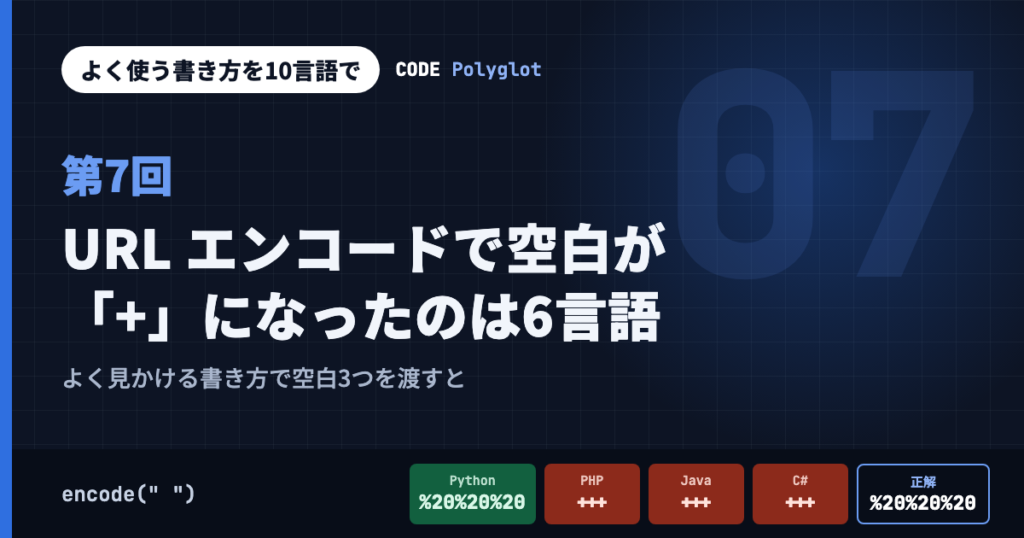
検索語や日本語の名前を ?q=... に入れるために URL エンコードする。どの言語にも関数があって、1行で済むはずの処理です。よく見かける書き方を10言語で試したところ、**空白3つを渡しただけで6言語が +++ を返しました**。
何をしたか
CODE Polyglot の「よく使う書き方」 で、決まりを先に決めました(正解表15件)。RFC 3986(URL の決まり)のとおりです。
- そのまま残すのは A〜Z a〜z 0〜9 と 「-」「_」「.」「~」の4つだけ
- それ以外は、UTF-8 のバイトに分けて1バイトずつ
%XX(大文字の16進数2桁)にする - 空白は
%20(+にしない)
10言語(PHP・Python・JavaScript・Go・Java・C#・Rust・Ruby・Kotlin・Swift)で書き、よく見かける書き方(各言語の「URL エンコード」の関数をそのまま呼ぶ)も10言語で用意して、同じ正解表で動かしました。
空白3つで、6言語が +++ を返した
空白だけを渡したケース(c013)の結果です。10言語中6言語が +++ を返しました。
| よく見かける書き方 | Hello, World! の答え |
|---|---|
| 決まり | Hello%2C%20World%21 |
PHP urlencode | Hello%2C+World%21 |
Go url.QueryEscape | Hello%2C+World%21 |
Java・Kotlin URLEncoder.encode | Hello%2C+World%21 |
Ruby CGI.escape | Hello%2C+World%21 |
C# WebUtility.UrlEncode | Hello%2C+World! |
JavaScript encodeURIComponent | Hello%2C%20World! |
Swift .urlQueryAllowed | Hello,%20World! |
+ を空白と読むのは、HTML のフォームを送るときの形(application/x-www-form-urlencoded)です。「URL エンコード」という名前の関数には、フォームの形と URL の形の2通りがあり、名前からはどちらか分かりません。
クエリの値なら + でも読める相手が多いのですが、同じ関数で作った文字列をパスの一部やヘッダーの値に入れると、+ がそのまま残って別の文字列になります。日本語(c005)でも、空白のところだけ + になりました。
~ を変えたのは4言語、関数によっても違う
a-b_c.d~e(c002)は、決まりではまったく変わりません。10言語中4言語(PHP・Java・Kotlin・C#)が a-b_c.d%7Ee を返しました。~ が「変えなくてよい文字」に入ったのは RFC 3986(2005年)からで、それより前の決まりで作られた関数は ~ を変えます。
同じ言語の中でも、関数によって違います。
CGI.escape("a-b_c.d~e !*")                   # => "a-b_c.d~e+%21%2A"
URI.encode_www_form_component("a-b_c.d~e !*") # => "a-b_c.d%7Ee+%21*"
Ruby 4.0.7 で確かめました。~ も * も違います。「どちらを使ってもだいたい同じ」ではありません。
! * ' ( ) の答えが4通りに割れた
この5文字だけを渡したケース(c003)です。
| よく見かける書き方 | !*'() の答え |
|---|---|
| 決まり | %21%2A%27%28%29 |
JavaScript encodeURIComponent | !*'() |
Swift .urlQueryAllowed | !*'() |
C# WebUtility.UrlEncode | !*%27() |
Java・Kotlin URLEncoder.encode | %21*%27%28%29 |
5文字とも、URL としては変えなくても読めます。ただし ' が残ったまま HTML の属性に入れると引用符を閉じてしまうので、全部変えておくほうが安全です。JavaScript で encodeURIComponent のあとに5文字だけ変える書き方が貼られているのは、この差を埋めるためです。
// 決まりに合わせる(! * ' ( ) の5文字だけ足す)
const q = encodeURIComponent(s).replace(/[!*'()]/g, (c) =>
  "%" + c.charCodeAt(0).toString(16).toUpperCase(),
);
標準の関数が無い言語で、文字とバイトを取り違える
Rust には標準に URL の関数がありません。「1文字ずつ見て、英数字でなければ %XX にする」という手書きの書き方は、15件中7件しか通りませんでした(10言語で唯一、半分を割りました)。
| 入力 | よく見かける書き方(Rust)の答え | 決まり |
|---|---|---|
天気 東京(c005) | 天気%20東京 | %E5%A4%A9%E6%B0%97%20%E6%9D%B1%E4%BA%AC |
🍣(c006) | %1F363 | %F0%9F%8D%A3 |
AB1(c007) | AB1 | %EF%BC%A1%EF%BC%A2%EF%BC%91 |
a-b_c.d~e(c002) | a%2Db%5Fc%2Ed%7Ee | a-b_c.d~e |
is_alphanumeric() は Unicode 全体を見るので、ひらがな・漢字・全角の英数字にも true を返します(第6回の slug と同じ問題です)。is_ascii_alphanumeric() に替えると日本語は %XX になりますが、**文字の値をそのまま16進数にすると %1F363 のように桁が増えます**。
パーセントエンコードは「1バイトを %XX 1つ」にする決まりです。先に UTF-8 のバイトに分けます。
for &b in s.as_bytes() {  // chars() ではなく as_bytes()
    let c = b as char;
    if c.is_ascii_alphanumeric() || matches!(c, '-' | '_' | '.' | '~') {
        out.push(c);
    } else {
        out.push_str(&format!("%{:02X}", b));
    }
}
Java と Kotlin の byte は符号付きなので、& 0xFF を付けないと %FFFFFFE3 のようになります。バイトに分けてあれば、濁点を分けて書いた「が」(c012。か+濁点の2文字)も素直に %E3%81%8B%E3%82%99 になり、絵文字の数え方も関係しなくなります。
「URL のどこを作るのか」で関数が変わる
https://example.com/?q=1&r=2(c004)をクエリの値として渡したときは、: も / も ? も & も変えます。2言語が違う答えを返しました。
- Python の
quote(s)はsafeの既定が"/"なのでhttps%3A//example.com/%3Fq%3D1%26r%3D2。パスを作るときの既定です - Swift の
addingPercentEncoding(withAllowedCharacters: .urlQueryAllowed)はクエリ全体(q=1&r=2)に使う集合なので、& = ? / :を残し、入力をほぼそのまま返しました
どちらも関数が悪いのではなく、値1つを作るのか、クエリ全体を作るのか、パスを作るのかで、許す文字が変わるということです。値1つなら、残す文字をいちばん少なくしておくと間違えません。
どう書いたか
決まりに合う書き方は、言語によって手間が違いました。
| 言語 | 書き方 | |
|---|---|---|
| 標準の関数そのまま | PHP・Python・C# | rawurlencode($s)・quote(s, safe="")・Uri.EscapeDataString(s) |
| 1行足す | JavaScript・Go | ! * ' ( ) を変える・QueryEscape の + を %20 にする |
| バイトを自分で回す | Java・Kotlin・Ruby・Rust・Swift | UTF-8 のバイトを1つずつ %XX にする |
PHP は urlencode と rawurlencode の2つがあり、後ろに raw が付くほうが URL の形です。C# の Uri.EscapeDataString は .NET 6 から RFC 3986 のとおりになりました(それより前は !*'() を残していました)。Go は QueryEscape のあとに + を %20 に置き換えるだけで済みます(入力にあった + は %2B になっているので、残っている + は空白から来たものだけです)。
10言語のコードは、どれも15件すべてで決まりどおりの答えを出しています。
まとめ
- 「URL エンコード」の関数は、フォームの形(空白が
+)と URL の形(空白が%20)の2通りある。名前だけでは分からないので、空白1文字で試す ~や!*'()を変えるかどうかは、言語と関数で割れる。値1つを作るなら、残す文字をA-Za-z0-9-_.~だけにそろえる- パーセントエンコードは文字ではなくバイトの処理。手で書くときは、先に UTF-8 のバイトに分ける
10言語のコードと全15件の結果は CODE Polyglot「URL エンコードする」 にあります。
- 第1回:HTML のエスケープ、標準の関数の答えが言語ごとに違った
- 第2回:「2026-02-30T09:00:00Z」を、4言語の標準のパーサーが3月2日として読んだ
- 第3回:「getHTTPResponseCode」をスネークケースに、よく見かける書き方は10言語中9言語で崩れた
- 第4回:アクセスログを空白で区切って集計したら、10言語すべてが壊れた行を数えた
- 第5回:重複を消したら順番が変わった、Swift は「が」を1つにまとめた
- 第6回:İstanbul の slug が5通りに割れた、日本語のタイトルはそのまま URL に入った
- 第7回:URL エンコードで空白が「+」になったのは10言語中6言語、~ を変えたのは4言語(この記事)