 Analyzegear
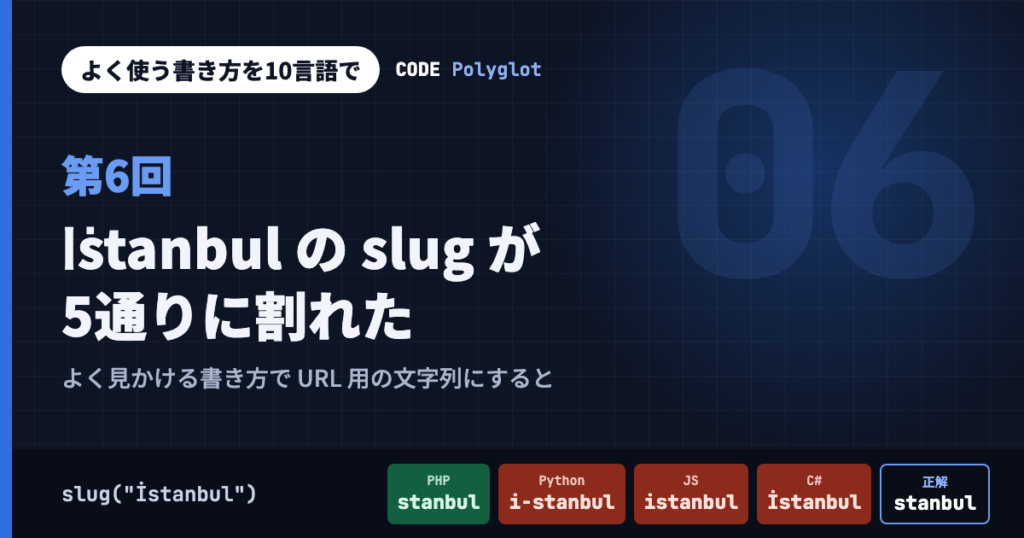
記事のタイトルから hello-world のような URL の一部(slug)を作る。ブログでも商品ページでもよく書く処理です。よく見かける書き方を10言語で試したところ、**İstanbul 1語で答えが5通りに割れました**。
何をしたか
CODE Polyglot の「よく使う書き方」 で、決まりを先に決めました(正解表14件)。
- 半角の A〜Z だけを小文字にする
- 半角の a〜z と 0〜9 を残し、それ以外は続いている分をまとめて「-」1つにする(「_」も「-」)
- 先頭と末尾の「-」を取り、32文字より長ければ切る
- 残る文字が無ければ
NG: URL に使える文字がありません
10言語(PHP・Python・JavaScript・Go・Java・C#・Rust・Ruby・Kotlin・Swift)で書き、よく見かける書き方(\W+ を「-」にする、is_alphanumeric で判断するなど)も10言語で用意して、同じ正解表で動かしました。
İstanbul の答えが5通りに割れた
トルコ語の「点の付いた大文字の I」İ(U+0130)で始まる İstanbul(c007)を渡した結果です。
| よく見かける書き方 | 答え |
|---|---|
| 決まり(A〜Z だけを小文字に) | stanbul |
PHP strtolower | stanbul |
| Python・Java・Rust・Ruby・Kotlin | i-stanbul |
| JavaScript・Go | istanbul |
C# ToLower() | İstanbul |
Swift lowercased() | i̇stanbul |
Unicode の決まりでは、İ を小文字にすると「i」+「上に付く点」の2文字になります。Python・Java・Rust・Ruby・Kotlin はこの決まりどおりに変えるので、点が「URL に使えない文字」になり、i と stanbul の間に「-」が入りました。JavaScript と Go は1文字の i にします(簡易の対応表を使うため)。C# の ToLower() は İ のまま変えず、\W が文字とみなしたので、大文字の İ が URL に残りました。Swift は2文字になったものを「1つの文字」として扱うので、点の付いた i がそのまま残っています。
決まりと同じ答えになったのは 10言語中 PHP だけでした。PHP の strtolower は 8.2 から ASCII の A〜Z だけを変えるようになったためで、たまたまです。
日本語のタイトルが、そのまま URL に入った
日本語のタイトル(c004)では、10言語中4言語(Python・C#・Rust・Swift)が 日本語のタイトル をそのまま返しました。全角の PHP8(c013)も、同じ4言語が php8 にしました。
| よく見かける書き方 | 日本語のタイトル の答え |
|---|---|
| 決まり | NG: URL に使える文字がありません |
Python \W+・C# \W+ | 日本語のタイトル |
Rust is_alphanumeric()・Swift isLetter | 日本語のタイトル |
| PHP・JavaScript・Go・Java・Kotlin・Ruby | (空の文字列) |
\w や「英数字か」を調べる関数が、言語によって Unicode 全体を見ます。Python と C# の \w、Rust の is_alphanumeric()、Swift の isLetter は、ひらがなや漢字にも合うので「残してよい文字」になります。
日本語の slug は、ブラウザのアドレス欄では読めますが、コピーすると %E6%97%A5%E6%9C%AC... に変わります。残すかどうかは好みですが、どちらにするかを決めて書く必要があります。残す文字を [a-z0-9] と書けば、どの言語でも同じ答えになります。
空のまま保存される
空の文字列(c011)と記号だけの !!! ---(c012)では、よく見かける書き方の 10言語すべてが空の行を出しました。日本語だけのタイトルでも、上の6言語は空になります。
slug が空のまま保存されると、/posts/ のような URL ができたり、2件目の記事で同じ空の slug がぶつかったりします。「空になった」ことを呼ぶ側に返して、日付や ID で別の名前を決められるようにしておきます。
「_」と、長さの上限
user_id--2(c003)では、10言語中5言語が決まりと違う答えを返しました。4言語は「_」を残し(\w と \W は Unicode を見る言語でも見ない言語でも「_」を単語の文字に入れます)、PHP は続いた「–」を残しました。
// PHP でよく貼られる書き方。許す文字に「-」が入っているので、もともとの「--」が残る
$slug = strtolower(trim(preg_replace('/[^A-Za-z0-9-]+/', '-', $s), '-'));
// user_id--2 → user-id--2(決まりは user-id-2)長さは、10言語すべてが切りませんでした。The Quick Brown Fox Jumps Over The Lazy Dog(c008)は43文字の slug になります。データベースの列の幅のために上限を決めるときは、切った位置が「-」に当たる場合(c009)に、もう一度末尾の「-」を取ります。
どう書いたか
10言語とも同じ順番で書いています。
1. 半角の A〜Z だけを小文字にする(toLowerCase() や downcase のような Unicode の小文字化は使わない)2. [a-z0-9] 以外を、続いている分まとめて「-」1つにする3. 先頭と末尾の「-」を取る4. 32文字で切り、末尾の「-」を取る5. 空なら NG を返す
s = s.translate(str.maketrans(string.ascii_uppercase, string.ascii_lowercase))
s = re.sub(r"[^a-z0-9]+", "-", s).strip("-")
Rust と Swift には標準の正規表現が無いので、1文字ずつ見て同じことをしています。Go の正規表現(RE2)には先読みがありませんが、[^a-z0-9]+ は使えます。
32文字を数えるところでは、「絵文字を何文字と数えるか」の問題が起きません。「-」にまとめたあとは半角の英数字と「-」だけになっていて、バイト数も文字数も同じになるからです。I 🍣 Sushi(c006)の絵文字も、line1\r\nline2(c014)の改行2文字も、1つの「-」にまとまります。
10言語のコードは、どれも14件すべてで決まりどおりの答えを出しています。
まとめ
- 小文字化は言語で結果が違う(
İは 2文字・1文字・変わらない の3通りに分かれた)。URL を作るなら A〜Z だけを変える \wや「英数字か」を調べる関数は、言語によって日本語にも合う。残す文字を[a-z0-9]と書く- slug が空になったときの答えを決めておく(黙って空を返さない)
10言語のコードと全14件の結果は CODE Polyglot「URL 用の文字列(slug)を作る」 にあります。
- 第1回:HTML のエスケープ、標準の関数の答えが言語ごとに違った
- 第2回:「2026-02-30T09:00:00Z」を、4言語の標準のパーサーが3月2日として読んだ
- 第3回:「getHTTPResponseCode」をスネークケースに、よく見かける書き方は10言語中9言語で崩れた
- 第4回:アクセスログを空白で区切って集計したら、10言語すべてが壊れた行を数えた
- 第5回:重複を消したら順番が変わった、Swift は「が」を1つにまとめた
- 第6回:İstanbul の slug が5通りに割れた、日本語のタイトルはそのまま URL に入った(この記事)